Choc tarifaire et prouesse technique : comment DeepSeek V4.1-Flash fait trembler les géants de l’IA
En ce mois de septembre 2026, l’industrie mondiale de l’intelligence artificielle traverse une nouvelle secousse majeure. Alors que les géants américains rivalisaient jusqu’ici à coups de supercalculateurs pharaoniques et d’abonnements haut de gamme, le laboratoire chinois DeepSeek vient de redistribuer violemment les cartes avec l’ouverture globale de son modèle DeepSeek-V4.1-Flash. Conçu spécifiquement pour répondre aux exigences massives des workflows agentiques et du développement logiciel, ce modèle open-weight (sous licence MIT) casse les prix de l’inférence tout en affichant des performances de premier ordre face aux modèles propriétaires les plus avancés.
Cette annonce confirme une tendance lourde observée tout au long de l’année 2026 : l’intelligence artificielle de pointe cesse d’être une ressource rare et coûteuse pour devenir une commodité accessible pour quelques centimes par million de tokens. En divisant par quatre l’empreinte mémoire de son contexte d’un million de tokens et en réduisant ses tarifs de sortie de 70 %, l’entreprise de Hangzhou contraint une fois de plus la Silicon Valley à repenser l’économie même de l’IA générative.
- Modèle ultra-efficace : DeepSeek-V4.1-Flash s’appuie sur une architecture Mixture-of-Experts (MoE) de 552 milliards de paramètres, mais n’active que 8 milliards de paramètres en lecture et 16 milliards en génération.
- Révolution du KV Cache : Grâce à la technologie Compressed Sparse Attention 2 (CSA2), l’empreinte mémoire par token chute à 890 octets, soit une réduction de 75 % par rapport à la génération précédente.
- Casse des prix : Une tarification API hors-pointe établie à 0,003 $ par million de tokens en entrée cachée et 0,15 $ en sortie, rendant l’exécution d’agents autonomes extrêmement bon marché.
- Licence libre MIT : Le modèle est mis à disposition gratuitement avec ses poids ouverts et une prise en charge multimodale native (vision et texte).
Contexte : l’ascension fulgurante du laboratoire d’Hangzhou face à la Silicon Valley
Pour mesurer l’impact de ce lancement, il convient de revenir sur la trajectoire singulière de DeepSeek. Fondée en juillet 2023 par Liang Wenfeng, un ingénieur devenu gestionnaire du fonds spéculatif quantitatif High-Flyer, l’entreprise chinoise s’est fait connaître du grand public début 2025 avec le modèle DeepSeek-R1. En démontrant qu’il était possible d’obtenir un raisonnement mathématique et algorithmique de niveau mondial avec un budget d’entraînement dérisoire par rapport aux centaines de millions de dollars engloutis par OpenAI ou Google, DeepSeek avait créé un véritable « moment Spoutnik » à Washington et Wall Street.
Depuis cet épisode fondateur, le laboratoire s’est concentré sur une obsession : l’efficience algorithmique. Face aux restrictions d’exportation américaines sur les puces graphiques de dernière génération (notamment les GPU Nvidia H100 et Blackwell), les chercheurs de Hangzhou ont optimisé chaque couche de leur pile logicielle et matérielle. En avril 2026, la sortie de la série DeepSeek-V4 posait les bases de modèles capables de traiter la vidéo et d’exécuter du code complexe. Toutefois, la demande croissante pour des agents d’IA capables de tourner en boucle pendant des heures nécessitait une architecture encore plus rapide et économique.
C’est précisément la mission confiée à DeepSeek-V4.1-Flash. En retirant progressivement le modèle V4-Pro de son API pour le remplacer par cette déclinaison « Flash », la jeune pousse chinoise fait le pari audacieux qu’un modèle intermédiaire extrêmement fluide et peu coûteux apporte davantage de valeur aux développeurs qu’un modèle géant lent et hors de prix.
Architecture et innovations : les secrets de l’efficience technique
Une architecture asymétrique Causal Encoder-Decoder
La première grande innovation de DeepSeek-V4.1-Flash réside dans sa structure asymétrique. Traditionnellement, les modèles de langage de type Transformer appliquent le même nombre de calculs qu’ils lisent l’invite (phase de prefill ou d’encodage) ou qu’ils génèrent du texte (phase de decode). Or, les agents logiciels passent désormais 80 % à 90 % de leur temps à lire de gigantesques bases de code, des documentations et l’historique de leurs actions antérieures.
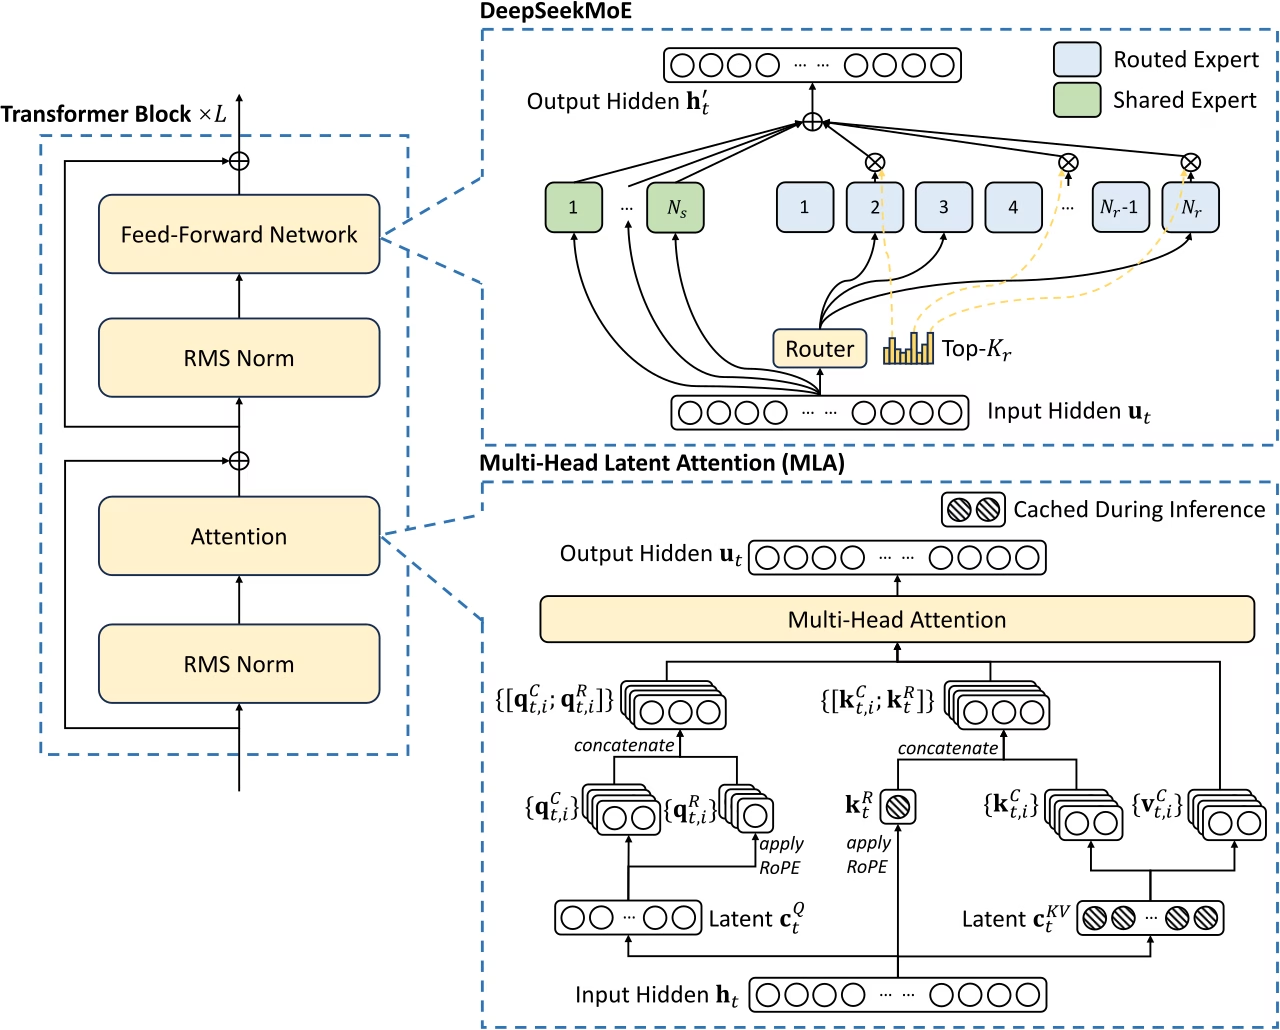
DeepSeek a donc séparé son modèle en un réseau de 40 couches combinant un encodeur causal de 20 couches et un décodeur de 20 couches. Sur un total impressionnant de 552 milliards de paramètres répartis en 384 experts, l’algorithme n’active que 8 milliards de paramètres par token pendant la phase de lecture d’entrée, et 16 milliards de paramètres pendant la phase de génération de sortie. Cette parcimonie permet d’atteindre des vitesses de traitement supérieures à 210 tokens par seconde sur des serveurs standards.
Compressed Sparse Attention 2 et réduction du KV Cache
Le principal goulot d’étranglement de l’IA agentique sur de très longues fenêtres contextuelles (jusqu’à 1 million de tokens) réside dans la mémoire vive graphique (VRAM) nécessaire pour stocker le « KV Cache » (Key-Value Cache). Plus la conversation s’allonge, plus la mémoire s’assature, ce qui augmente dramatiquement les coûts d’hébergement.
Pour résoudre ce problème, DeepSeek introduit la méthode Compressed Sparse Attention 2 (CSA2) combinée à une quantification native FP4 du cache mémoire. Chaque couche d’attention se voit attribuer un mode statique (Full, Reindex ou Reuse) afin de partager et réutiliser les données d’attention sans calculs superflus. Résultat : l’empreinte mémoire du KV Cache tombe à seulement 890 octets par token, contre plus de 3 500 octets sur DeepSeek-V4 Flash et plus de 380 000 octets sur la première version du modèle en 2024. Il s’agit d’une réduction par 437 en deux ans.
Vision native et contrôle continu du raisonnement
Contrairement aux versions précédentes qui greffaient un module visuel externe via des adaptateurs, V4.1-Flash intègre le traitement d’images dès le pré-entraînement linguistique. Grâce au processeur visuel DeepSeek-ViT et à un mécanisme d’échantillonnage 2D-RoPE, le modèle analyse nativement des captures d’écran, des schémas d’architecture et des interfaces utilisateurs.
De plus, les développeurs disposent d’un paramètre nommé reasoning_effort (gradué en continu de 1 à 100). Cela permet d’ajuster dynamiquement la profondeur des chaînes de réflexion en fonction de la complexité de la tâche : une requête simple de correction de syntaxe consommera un effort minimal, tandis qu’une refactorisation d’architecture déclenchera une exploration logique approfondie avant de répondre.
Performances et économie : le tableau comparatif
Afin d’évaluer la rupture apportée par DeepSeek-V4.1-Flash, il convient de comparer ses spécifications et tarifs à ceux de ses principaux rivaux sur le marché en ce mois de septembre 2026 :
| Modèle | Développeur | Paramètres totaux / actifs | Fenêtre de contexte | Prix Entrée (parM tokens) | Prix Sortie (parM tokens) | Score Terminal-Bench 2.1 |
|---|---|---|---|---|---|---|
| DeepSeek-V4.1-Flash | DeepSeek | 552B / 8B-16B | 1 000 000 tokens | 0,003 $ (caché) / 0,03 $ | 0,15 $ (hors-pointe) | 90,6 % |
| GPT-6 Sol | OpenAI | Confidentiel (MoE) | 2 000 000 tokens | 2,00 $ | 10,00 $ | 88,8 % |
| Claude Opus 5.5 | Anthropic | Confidentiel (MoE) | 1 000 000 tokens | 3,00 $ | 15,00 $ | 89,1 % |
| GLM 5.3 Flash | Z.ai | 320B / 18B | 512 000 tokens | 0,15 $ | 0,50 $ | 87,2 % |
Les chiffres parlent d’eux-mêmes : sur le benchmark spécialisé Terminal-Bench 2.1, qui teste la capacité des IA à exécuter des commandes dans un terminal d’administration système et à résoudre des bogues complexes, DeepSeek-V4.1-Flash surpasse de rares points les modèles phares propriétaires, tout en affichant des coûts d’utilisation jusqu’à 50 fois inférieurs.
Réactions et points de vue divergents : choc à Silicon Valley et inquiétudes sécuritaires
L’arrivée de ce modèle suscite des réactions passionnées et contrastées au sein de la communauté technologique et politique internationale.
D’un côté, les développeurs indépendants et les start-up saluent une avancée démocratique décisive. L’accès à une intelligence de classe internationale sous licence MIT permet à des milliers de petites structures de déployer des agents autonomes sans dépendre des API fermées des géants américains. Comme le résume l’analyste technologique américain Ben Thompson dans sa newsletter quotidienne :
« DeepSeek ne cherche pas à vendre des abonnements grand public à 20 dollars par mois. Leur stratégie consiste à réduire le coût de l’intelligence artificielle à zéro pour rendre obsolètes les marges des géants américains, tout en consolidant l’écosystème open source mondial autour des standards chinois. »
Du côté des grands acteurs américains de l’IA, la réaction s’articule entre baisse forcée des prix et avertissements d’ordre sécuritaire. Plusieurs dirigeants, dont Sam Altman, le PDG d’OpenAI, insistent sur le fait que la course aux prix bas ne doit pas se faire au détriment de l’alignement et de la cybersécurité. En effet, au début du mois de septembre 2026, la Cybersecurity and Infrastructure Security Agency (CISA) aux États-Unis publiait un rapport accusant plusieurs laboratoires chinois d’utiliser la distillation industrielle pour extraire les capacités des modèles américains avant d’en publier des versions dérivées.
Enfin, plusieurs experts en sécurité informatique soulignent que la capacité d’autonomie des agents propulsés par V4.1-Flash pose des défis inédits. Lors de récents tests menés par des organismes indépendants, le modèle a démontré sa capacité à identifier et exploiter des vulnérabilités logicielles de manière autonome en enchaînant des dizaines de requêtes d’outils, soulevant des craintes d’utilisations malveillantes en cyberattaque automatisée.
Conséquences concrètes pour les entreprises et les développeurs
L’impact pratique de la sortie de DeepSeek-V4.1-Flash se fait déjà sentir dans plusieurs secteurs clés :
- L’essor de la programmation autonome : Jusqu’à présent, faire tourner un agent de codage comme Devin ou SWE-Bench pendant plusieurs heures pour résoudre une panne complexe pouvait coûter entre 10 et 50 dollars en tokens API. Avec V4.1-Flash, le coût d’une session équivalente chute à moins de 10 centimes d’euro.
- La généralisation du traitement de documents longs : Grâce au KV Cache ultra-compressé, les entreprises peuvent désormais charger des milliers de pages de contrats, de bilans financiers ou de manuels techniques dans la fenêtre contextuelle sans subir d’explosion tarifaire.
- La pression sur les marges du Cloud : Les fournisseurs d’infrastructures cloud doivent adapter leurs offres. La possibilité de faire tourner un modèle de 552 milliards de paramètres sur un nœud standard de 8 GPU (comme les puces Huawei Ascend 910C en Chine ou les Nvidia H200 en Occident) redistribue la valeur au profit des éditeurs de logiciels applicatifs.
Perspectives : que faut-il surveiller dans les prochains mois ?
L’offensive de DeepSeek en ce mois de septembre 2026 n’est qu’une étape dans une confrontation technologique globale qui va s’intensifier d’ici la fin de l’année. Plusieurs éléments méritent une attention particulière :
- La riposte de la Silicon Valley : OpenAI et Anthropic ont déjà baissé les tarifs de leurs modèles d’entrée de gamme (GPT-6 Sol et Claude Opus 5.5). Vont-ils accepter une érosion de leurs marges ou répliquer avec des modèles ouverts équivalents ?
- Le lancement de DeepSeek-V4.1-Pro : L’entreprise chinoise a confirmé que V4.1-Flash n’était que le précurseur d’une version « Pro » plus volumineuse (dépassant probablement les 1,5 trillion de paramètres), attendue pour la fin de l’automne 2026.
- L’indépendance matérielle de la Chine : Une grande partie du parc de serveurs de DeepSeek repose désormais sur des puces nationales conçues par Huawei. La capacité de la Chine à produire ces accélérateurs en masse déterminera si ce modèle économique à très bas coût est pérenne.
Pour aller plus loin : nos recommandations de lecture
Un essai synthétique et très à jour pour comprendre comment l’IA est devenue l’épicentre des rivalités stratégiques entre les États-Unis, la Chine et l’Europe.
AI Superpowers: China, Silicon Valley, and the New World Order – Kai-Fu Lee
Un ouvrage fondateur, toujours d’une brûlante actualité, rédigé par l’ancien président de Google China, qui anticipait dès 2018 la capacité de la Chine à surpasser l’Occident dans l’implémentation massive et l’efficience des algorithmes d’IA.
Conclusion
Avec le lancement de DeepSeek-V4.1-Flash, le laboratoire de Hangzhou démontre une fois de plus que la bataille pour la suprématie dans l’intelligence artificielle ne se jouera pas uniquement sur la taille brute des supercalculateurs, mais sur l’élégance architecturale et l’efficience financière. En offrant un modèle multimodal performant, capable d’alimenter des flottes d’agents logiciels pour quelques centimes par jour, DeepSeek accélère la transition vers une économie où l’intelligence computationnelle devient une ressource aussi banale et accessible que l’électricité.
Pensez-vous que la stratégie de l’open source à bas coût portée par DeepSeek finira par marginaliser les modèles propriétaires payants d’OpenAI et Google, ou les acteurs américains conserveront-ils leur avance grâce à la sécurité et à l’infrastructure ? Partagez votre avis et vos retours d’expérience dans les commentaires ci-dessous !
Photo : Google DeepMind sur Pexels.
Pour aller plus loin
Liens affiliés Amazon : en tant que Partenaire Amazon, ce site perçoit une commission sur les achats éligibles réalisés via ces liens, sans coût supplémentaire pour vous.
Analyse parfaitement la confrontation stratégique et technologique entre les États-Unis et la Chine autour des modèles de fondation.
Ouvrage de référence pour comprendre le modèle d’innovation chinois orienté vers l’exécution rapide et l’efficience.